No es el benchmark definitivo: un taller para probar stacks
Hay discusiones en informática que probablemente no terminarán nunca.
PHP o Python. Node o Go. Java, Kotlin, frameworks, runtimes...
Y casi siempre aparece alguien dispuesto a explicar cuál es más rápido, más eficiente o más adecuado.
El problema es que opinar es fácil; medir ya es otra cosa.
Así que he montado un pequeño laboratorio con una idea bastante sencilla: implementar el mismo contrato de una API en varios stacks, ponerlos a hacer el mismo trabajo y observar qué ocurre.
No pretende descubrir cuál es el mejor lenguaje.
Tampoco es el benchmark definitivo.
Es algo bastante más modesto y, para mí, más útil:
un taller para probar stacks.
El proyecto es software libre y está disponible en GitHub.
El experimento
He implementado la misma API con cinco tecnologías:
- PHP con FrankenPHP.
- Python con FastAPI.
- Kotlin con Ktor.
- Node.js con Fastify.
- Go con
net/http.
Todas hablan con PostgreSQL y exponen el mismo contrato HTTP.
La idea no es que sean idénticas por dentro, sino que el cliente pueda pedirles el mismo trabajo.
Lo que este artículo no dice
Este experimento no demuestra qué lenguaje es mejor.
Mide estas implementaciones, en este equipo, con este contrato, esta base de datos y estos límites de CPU y memoria.
Cambiar el framework, el driver SQL, el hardware, la configuración o las consultas puede cambiar el resultado.
Por eso prefiero hablar de laboratorio antes que de competición.
Antes de empezar: cuatro palabras que vamos a usar
No hace falta conocer la jerga para seguir el experimento.
RPS
RPS significa Requests Per Second: peticiones por segundo.
Si pruebo a 200 RPS, intento entregar a la API unas 200 peticiones cada segundo.
Latencia
Es el tiempo que tarda una petición en recibir respuesta.
Menos tiempo, en principio, significa una respuesta más rápida.
p95
El percentil 95 es una forma práctica de hablar de latencia.
Si el p95 es 20 ms, aproximadamente el 95 % de las peticiones ha tardado 20 milisegundos o menos.
Endpoint
Es una operación concreta de la API: listar usuarios, consultar /me, crear registros, etc.
Cómo está montada la prueba
La prueba principal utiliza 10.000 registros y tres perfiles de carga:
- Lectura: predominan las consultas.
- Mixto: combina lecturas, comprobaciones de sesión y algunas escrituras.
- Escritura intensa: aumenta deliberadamente las escrituras para someter a más presión a las transacciones y a PostgreSQL.
Para cada perfil probé 25, 50, 100, 200 y 400 RPS.
Cada punto se ejecutó tres veces, con 30 segundos de medición y 10 segundos previos de calentamiento.
Además, la base de datos se recrea para cada punto de prueba y se rota el orden de los stacks entre rondas para intentar reducir parte del ruido del propio equipo.
No convierte la prueba en perfecta.
Pero sí intenta que la comparación sea razonablemente justa.
¿Cuánta carga llega de verdad?
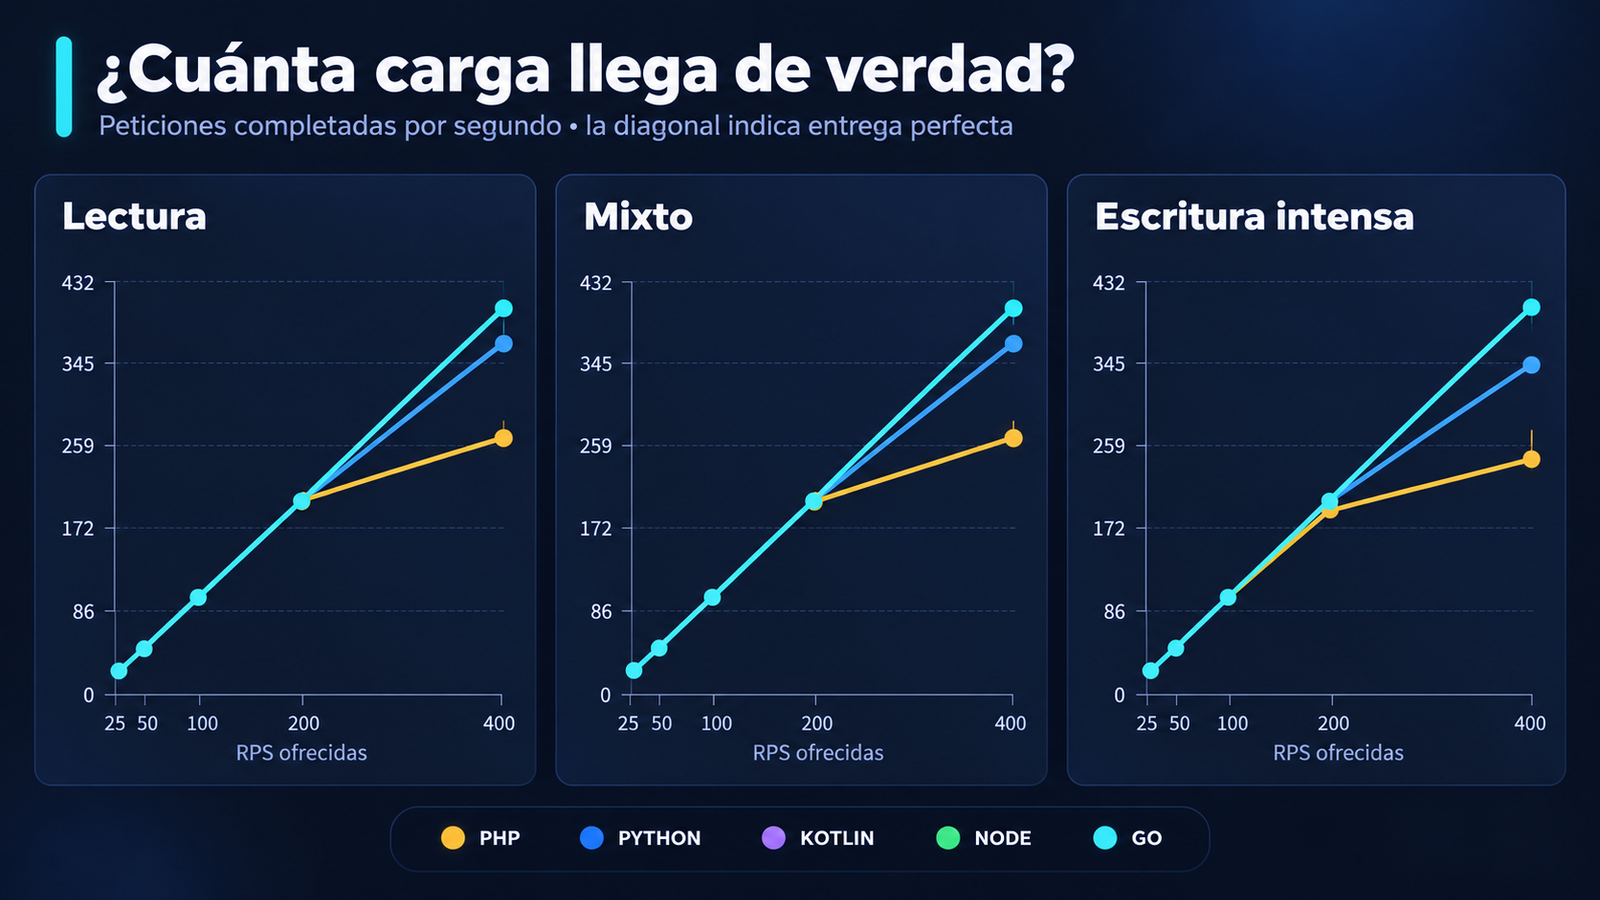
Esta es probablemente la gráfica más sencilla de leer.
En el eje horizontal está la carga que intentamos enviar: las RPS ofrecidas.
En el vertical está lo que realmente consigue terminar la aplicación: las RPS completadas.
La diagonal representa el caso ideal.
Si ofrezco 100 peticiones por segundo y completo aproximadamente 100, la línea sigue la diagonal. Si ofrezco 400 y solo completo 250, empieza a separarse de ella.
Dicho en corto:
una cosa es la carga que intento enviar y otra la que realmente llega al final.
A cargas pequeñas hay pocas diferencias.
Cuando aumentamos la presión empiezan a aparecer.
PHP es el primero que se separa claramente. Python aguanta algo más. Kotlin, Node y Go permanecen mucho más cerca de la carga ofrecida dentro del rango principal.
Pero aquí hay una trampa: una aplicación puede seguir completando muchas peticiones y hacerlo cada vez más despacio.
Por eso necesitamos mirar también la latencia.
La latencia revela el límite
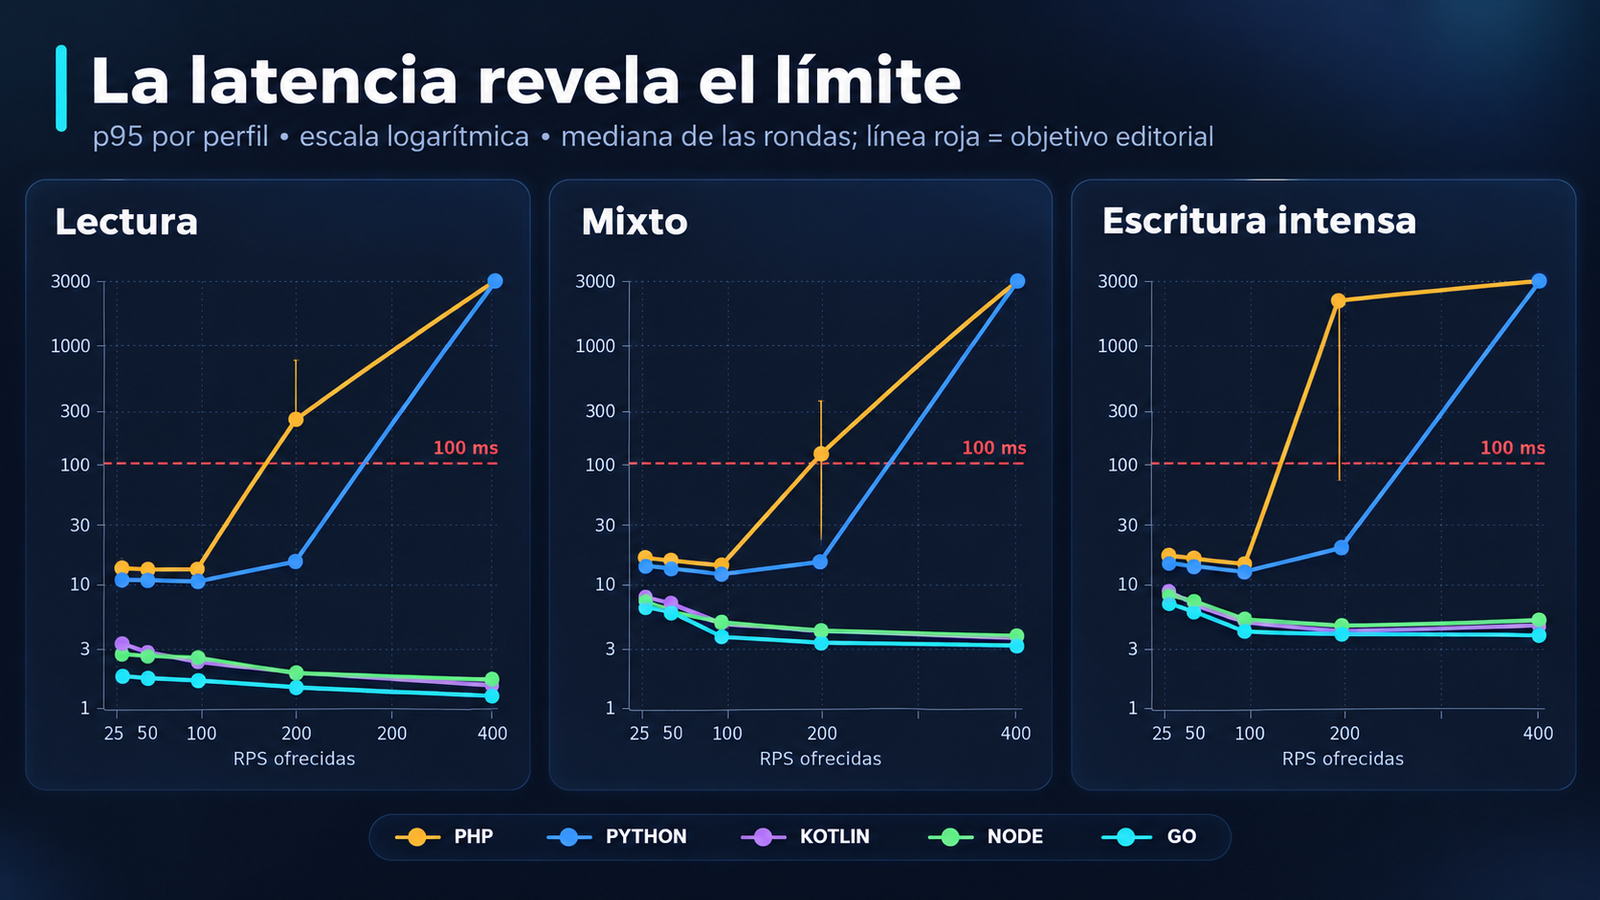
La línea roja está situada en 100 ms.
No es una frontera universal ni significa que una API que tarde 101 ms sea mala.
Es simplemente el criterio que he elegido para este laboratorio: necesitaba una referencia común para decidir cuándo considero que una prueba empieza a dejar de ser cómoda.
A 200 RPS, por ejemplo, las medianas del p95 en el perfil mixto fueron:
| Stack | p95 a 200 RPS |
|---|---|
| PHP | 118,89 ms |
| Python | 14,03 ms |
| Kotlin | 3,92 ms |
| Node | 3,85 ms |
| Go | 3,14 ms |
En esta ejecución, Go presenta el p95 más bajo a 200 RPS en los tres perfiles.
Kotlin y Node también mantienen latencias muy pequeñas dentro de buena parte del rango ensayado.
Pero un número global todavía puede esconder mucho.
Así que bajemos un nivel más.
El endpoint cambia la historia
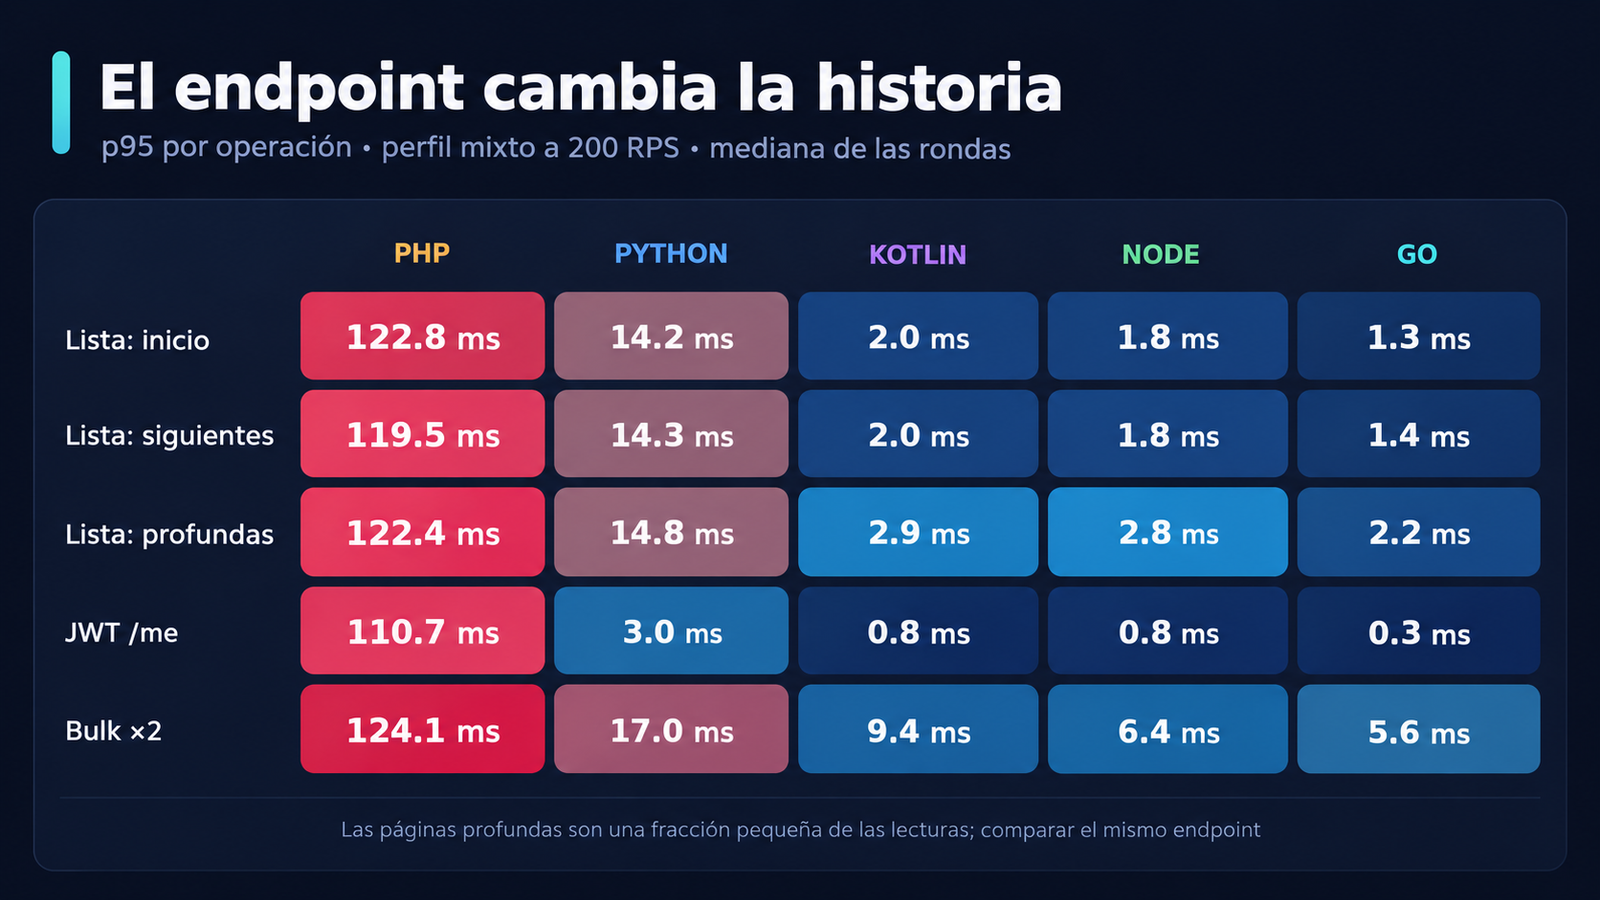
Aquí ya no estamos mirando únicamente la API en conjunto.
Estamos mirando operaciones concretas:
- primeras páginas del listado;
- páginas siguientes;
- páginas profundas;
- comprobación de sesión mediante
/me; - inserciones en lote.
Y el dibujo cambia bastante.
En el perfil mixto a 200 RPS, PHP ronda aproximadamente los 110–124 ms en estas operaciones.
Python se mueve entre unos 3 y 17 ms.
Kotlin, Node y Go están casi siempre en cifras de un solo dígito.
Pero lo importante no es proclamar un ganador.
Lo interesante es otra cosa:
el número global puede ocultar dónde está realmente el coste.
Cuando una operación concreta empieza a ir mal, ya podemos hacer preguntas mejores.
¿Es la consulta SQL?
¿El driver?
¿La serialización?
¿El pool de conexiones?
¿Una decisión de implementación?
Ahí es donde un benchmark empieza a ser útil como herramienta de diagnóstico y deja de ser simplemente una tabla de tiempos.
Una regla para decir «esto aguanta»
Para resumir el resultado necesitaba una definición común de capacidad sostenible observada.
En este laboratorio considero que una tasa es sostenible si todas las rondas cumplen simultáneamente:
- al menos el 99 % de la carga ofrecida completada;
- p95 ≤ 100 ms;
- fallos ≤ 1 %;
- 0 iteraciones descartadas.
No es un SLA comercial ni una norma de la industria.
Es una regla del experimento.
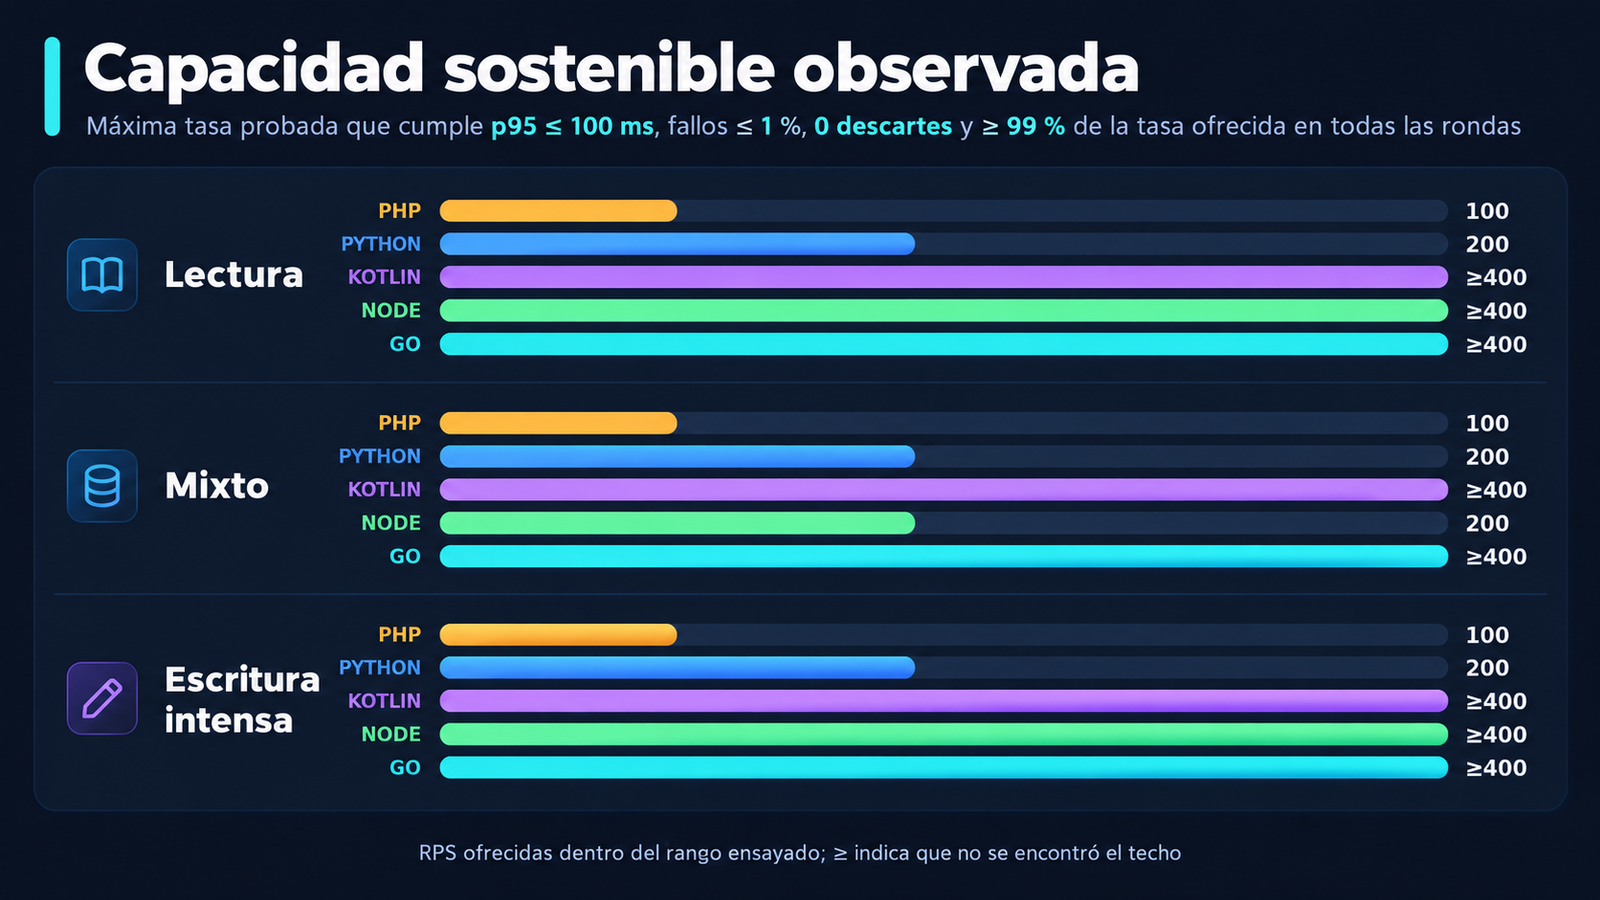
El resumen de la prueba principal queda así:
| Stack | Lectura | Mixto | Escritura intensa |
|---|---|---|---|
| PHP | 100 RPS | 100 RPS | 100 RPS |
| Python | 200 RPS | 200 RPS | 200 RPS |
| Kotlin | ≥400 RPS | ≥400 RPS | ≥400 RPS |
| Node | ≥400 RPS | 200 RPS | ≥400 RPS |
| Go | ≥400 RPS | ≥400 RPS | ≥400 RPS |
Hay un detalle importante:
≥400 no significa que el límite sea 400.
Significa que llegamos a la máxima carga de esa prueba y todavía no encontramos el techo.
Espera... ¿Node se queda en 200 RPS en el perfil mixto?
Sí.
Y esta es una de las partes más interesantes del experimento.
La gráfica de latencia muestra la mediana de las tres rondas.
Sin embargo, para declarar una tasa sostenible exijo que todas las rondas superen todos los criterios: throughput, p95, fallos y descartes.
Por eso un punto puede mostrar una mediana aparentemente excelente y no superar finalmente el criterio de capacidad sostenible.
El resumen de la prueba principal deja Node en 200 RPS para el perfil mixto.
Y después ocurrió algo bastante más extraño.
¿Qué pasa si subimos mucho más la carga?
Hice una segunda prueba exploratoria, esta vez solo con Kotlin, Node y Go.
En lugar de quedarme en 400 RPS probé 1.600 y 3.200 RPS.
A 1.600 RPS obtuve:
| Stack | Completadas | p95 | Fallos | Descartadas |
|---|---|---|---|---|
| Kotlin | 1.419,9 RPS | 1.513,5 ms | 0,00 % | 2.700 |
| Node | 1.600,1 RPS | 3,36 ms | 0,00 % | 0 |
| Go | 765,3 RPS | 18.913,4 ms | 0,01 % | 12.520 |
Node sostuvo los 1.600 RPS prácticamente completos, con un p95 de solo 3,36 ms y sin descartes.
A 3.200 RPS ninguno de los tres cumplió ya el criterio de sostenibilidad.
Y aparece una pregunta bastante evidente:
¿Cómo puede Node quedarse en 200 RPS sostenibles en el perfil mixto de una prueba y después soportar 1.600 RPS con esa latencia?
No tengo una explicación suficientemente sólida.
Y no quiero inventarla.
La segunda ejecución tiene además una limitación importante: fue una sola ronda de 15 segundos, mientras que la prueba principal utilizó tres rondas más largas.
Por tanto, debe leerse como una exploración del techo, no como una medición con la misma confianza estadística.
Puede existir una explicación perfectamente razonable.
Puede haber variabilidad entre rondas.
Puede influir la JVM, el recolector de basura, el pool SQL, el estado del host o algún detalle de implementación.
O puede haber algo que mejorar en el propio laboratorio.
Y precisamente para eso está el laboratorio.
La parte divertida: puedes repetirlo tú
El proyecto está publicado.
No tienes por qué creer mis resultados.
Puedes intentar reproducirlos.
git clone https://github.com/alxarafe/saas.git
cd saas
docker compose build
./bin/dashboard.sh
Después puedes abrir:
http://localhost:8090Desde el dashboard se pueden seleccionar perfiles, tasas, repeticiones, duración, tamaño del conjunto de datos y número máximo de usuarios virtuales.
Así que, si la aparente contradicción de Node te pica la curiosidad, hay una forma bastante directa de investigarla:
arranca Docker, ejecuta las pruebas en tu máquina y mira qué ocurre.
Quizá obtengas algo parecido.
Quizá salga completamente distinto.
Quizá encuentres la causa.
Eso no estropea el experimento.
Eso es el experimento.
Entonces, ¿cuál es el mejor stack?
Después de todo esto, mi respuesta sigue siendo:
depende.
Pero ahora ese «depende» tiene algo más de contenido.
En esta prueba, con estas implementaciones, este contrato, este host, PostgreSQL y estos límites de recursos:
- PHP es el primero que encuentra dificultades.
- Python queda en una posición intermedia.
- Kotlin, Node y Go forman el grupo con mayor margen dentro del rango principal.
- Go muestra latencias especialmente bajas a 200 RPS.
- Kotlin se mantiene sólido en los tres perfiles.
- Node deja una de las preguntas más interesantes de la prueba.
Eso es lo que hemos medido.
Nada más.
Y tampoco nada menos.
Lo que falta en este laboratorio
Una aplicación SaaS real puede incluir muchas otras cosas:
- TLS.
- cachés.
- colas.
- servicios externos.
- búsquedas complejas.
- autenticación con hashing real.
- más datos.
- otras consultas.
- otra infraestructura.
Todo eso puede cambiar el resultado.
Lo que sí tenemos
Tenemos un entorno donde podemos:
- repetir la prueba;
- cambiar una pieza;
- medir otra vez;
- comparar resultados;
- detectar anomalías;
- y formular preguntas mejores.
Para mí, ese es el valor del proyecto.
Un taller, no un podio
Este proyecto empezó como una comparación de stacks.
Cada vez lo veo más como un banco de pruebas en el que poder preguntar:
¿Y qué pasa si cambio esto?
Otro framework.
Otro driver.
Más datos.
Más CPU.
Menos memoria.
Una caché.
TLS.
Consultas distintas.
Otro stack.
Y volver a medir.
Porque un benchmark puede utilizarse para fabricar un titular.
Pero también puede servir para algo bastante más interesante:
hacer mejores preguntas.
El código está en:
https://github.com/alxarafe/saas
Si quieres comprobar los resultados, cambia lo que quieras, ejecuta las pruebas y mide otra vez.